Posez la question « quelle IA choisir » à dix personnes, vous obtiendrez dix réponses, toutes sincères et toutes partielles. Celle qui code jurera par un modèle, celle qui rédige par un autre, celle qui génère des images par un troisième. Elles ont toutes raison, et c’est précisément le problème : il n’existe pas de meilleure IA, il existe une meilleure IA pour ce que vous voulez en faire.
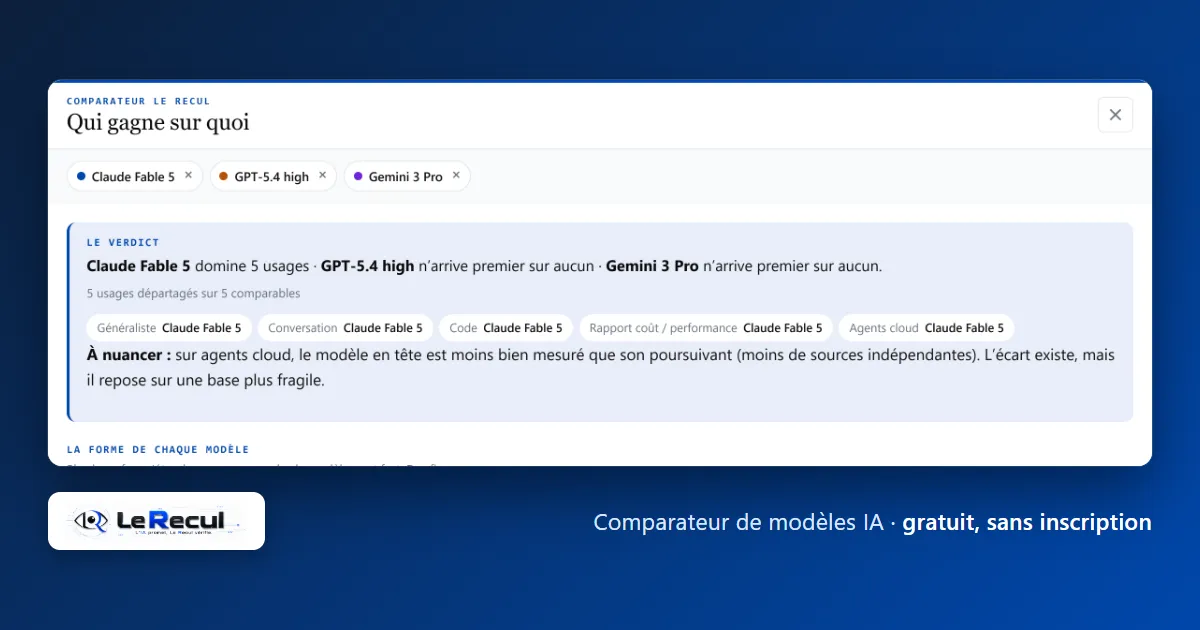
C’est la raison pour laquelle nous avons construit un comparateur de modèles IA. Vous cochez jusqu’à trois modèles, vous cliquez, vous obtenez le verdict usage par usage : qui gagne, de combien, et avec quelle solidité de mesure. Il est gratuit, sans inscription, sans compte. Et il fait une chose que les comparatifs d’outils IA ne font presque jamais : quand l’écart est plus petit que la marge d’erreur, il refuse de désigner un vainqueur.
Voici comment s’en servir, ce que chaque chiffre veut dire, d’où viennent les données — et ce que l’outil ne sait pas faire.
Quelle IA choisir ? La bonne question n’est pas celle-là
Un seul exemple suffit à casser l’idée de classement unique. Voici trois modèles très connus, relevés dans notre classement le 18 septembre 2026, avec leur score sur 100 et leur rang dans chaque catégorie.
| Usage | Claude Fable 5 | GPT-5.4 high | Gemini 3 Pro |
|---|---|---|---|
| Généraliste | 100,0 — 1er | 94,6 — 9e | 94,2 — 11e |
| Conversation | 100,0 — 1er | 94,6 — 27e | 96,2 — 20e |
| Code | 75,0 — 18e | non mesuré | 48,3 — 179e |
| Rapport coût / performance | 100,0 — 8e | 94,6 — 31e | 96,2 — 26e |
| Agents cloud | 100,0 — 1er | non mesuré | 94,2 — 8e |
Regardez la ligne surlignée. Le même modèle, Gemini 3 Pro, est 20e en conversation et 179e en code. Un lecteur qui aurait choisi son abonnement sur le seul classement généraliste — où l’écart entre le 9e et le 11e tient dans quatre dixièmes de point — se serait trompé de moitié s’il voulait surtout coder.
C’est pour cette raison que « quelle est la meilleure IA » est une question sans réponse utile, et que « quelle IA pour quel usage » en a une.
Le comparateur en une minute
Avant le mode d’emploi détaillé, voici le tour du propriétaire. Cette vidéo d’une minute est celle qui présente l’outil sur le site ; la page d’accueil en diffuse une version courte de dix-sept secondes, dans un bandeau qui s’effacera de lui-même début octobre. Cet article, lui, reste.
En résumé, l’outil couvre 1 892 modèles au relevé du 18 septembre 2026 et treize usages. Il ne demande ni compte, ni adresse e-mail, ni paiement. Les scores sont recalculés une fois par jour, et chaque comparaison affiche la date des données qu’elle utilise.
Les treize usages ne sont pas un habillage : ils correspondent à des classements distincts, alimentés par des sources différentes.
| Famille | Usages comparés |
|---|---|
| Usages généraux | Généraliste · Conversation · Code · Rapport coût / performance |
| Agents autonomes | Agents cloud · Agents de code · Agents locaux |
| Création | Image · Vidéo · Audio |
| Modèles ouverts et locaux | Open source / poids ouverts · Local — conversation · Local — code |
Mode d’emploi : cocher, comparer, lire
Tout tient en trois gestes, et aucun ne demande de connaissance technique.
1. Cochez jusqu’à trois modèles. La case se trouve tout à gauche de chaque ligne, dans le tableau du comparateur comme dans n’importe quel tableau du classement IA. Une barre apparaît en bas de l’écran et récapitule votre sélection.
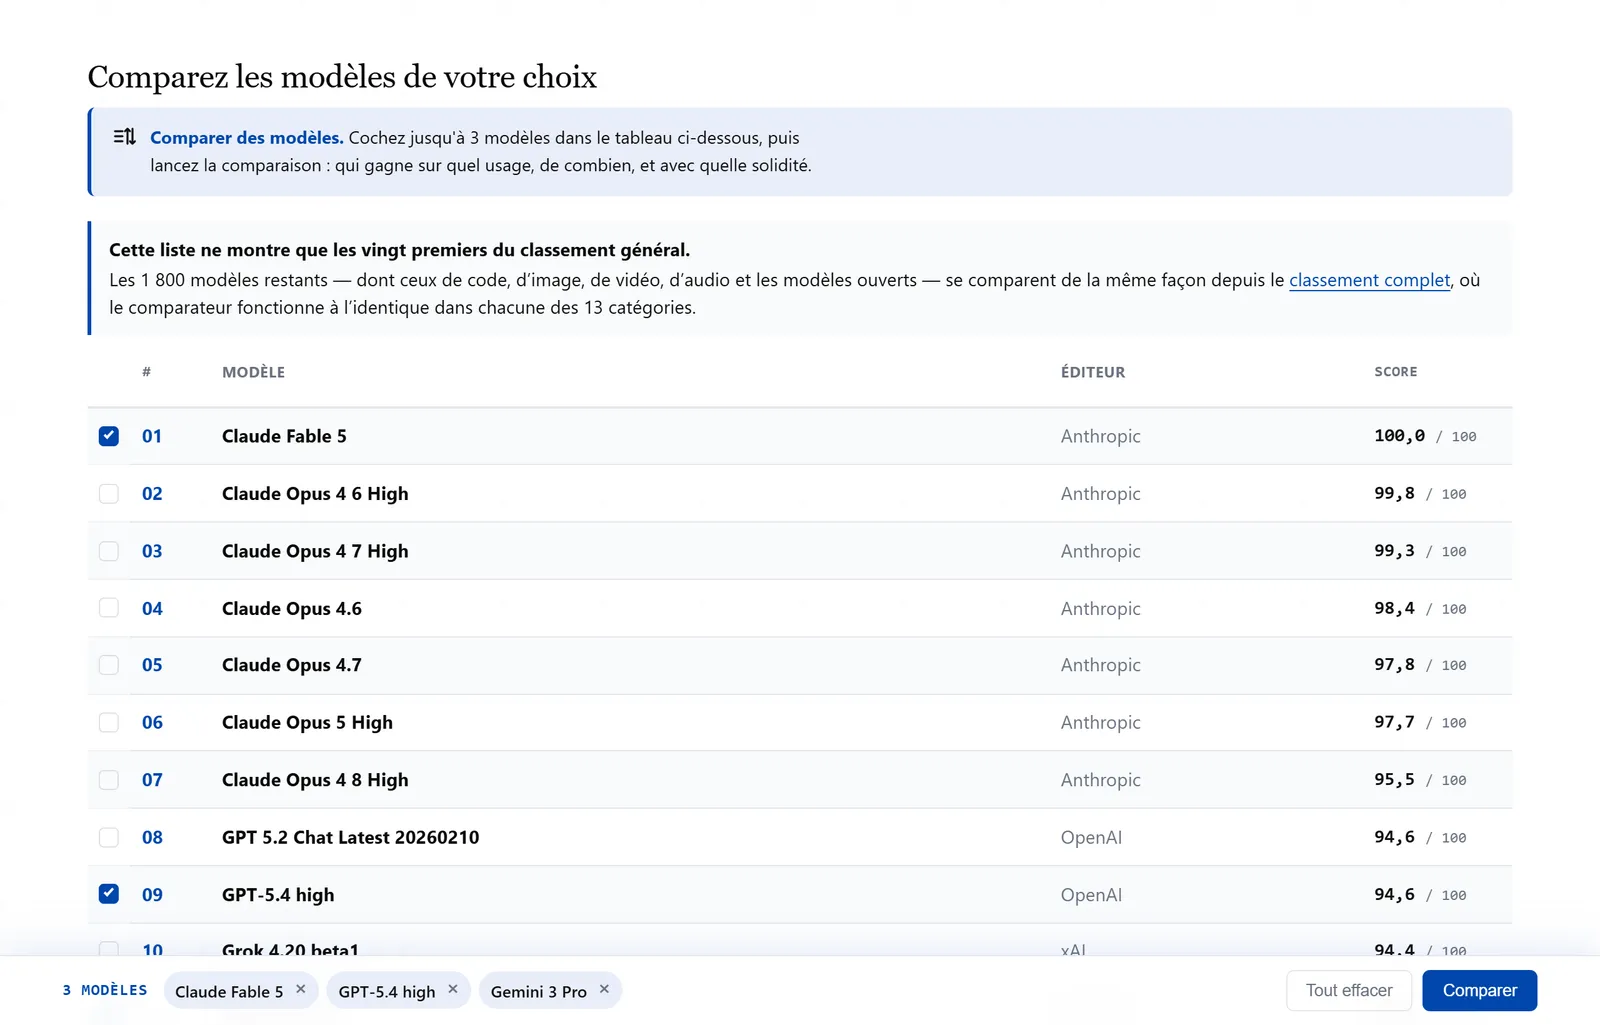
2. Cliquez sur « Comparer ». Rien à installer, rien à créer, aucun prompt à écrire : la comparaison est déjà calculée côté serveur, elle s’affiche immédiatement.
3. Lisez le verdict, usage par usage. C’est la partie qui mérite qu’on s’y arrête, et l’objet des trois sections suivantes.
Deux détails qui font gagner du temps :
- votre sélection vous suit d’une page à l’autre pendant votre visite. Vous pouvez cocher un modèle dans le classement Conversation, un autre dans le classement Code, un troisième dans le classement Image, puis lancer la comparaison : les trois sont toujours là ;
- le bouton « Copier le tableau », en bas du panneau, copie la comparaison en texte. Pratique pour la coller dans un message, un compte rendu ou une discussion d’équipe.
Sur téléphone, l’outil fonctionne à l’identique : le panneau occupe l’écran, les chiffres restent lisibles, rien n’est amputé.
Le verdict : qui gagne, de combien, et avec quelle solidité
Le panneau s’ouvre sur une phrase en clair — « X domine 5 usages, Y n’arrive premier sur aucun » — suivie du décompte des usages départagés, puis d’une pastille par usage avec le nom du gagnant.
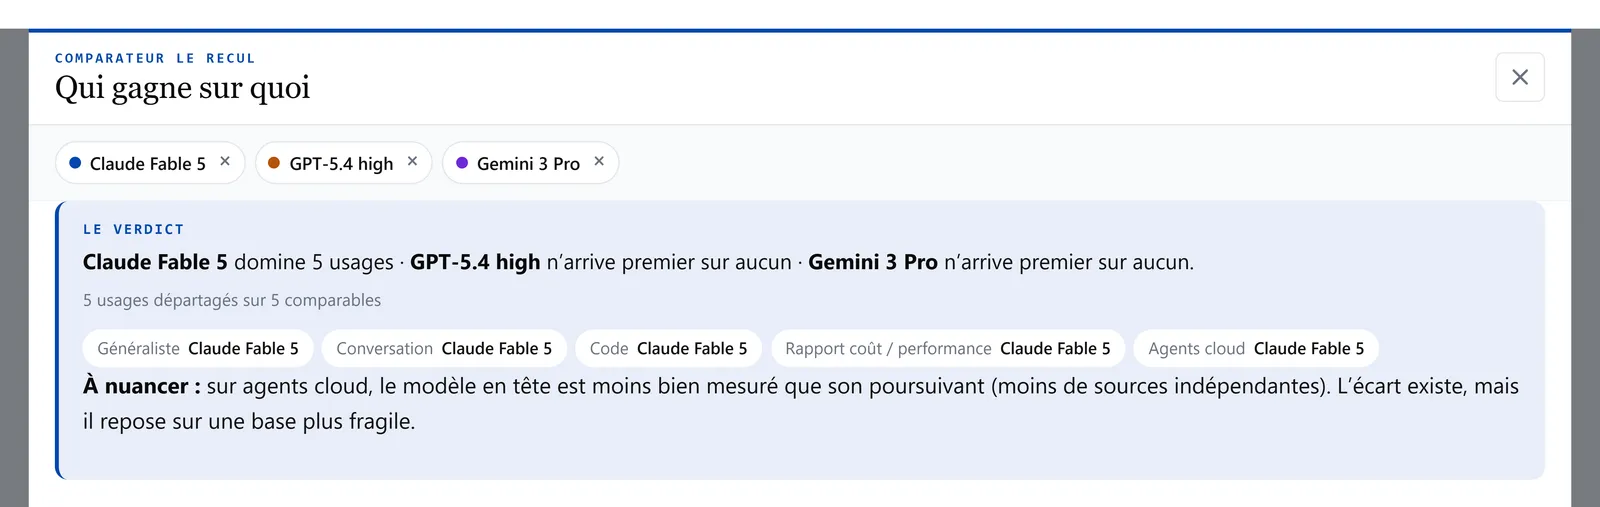
La ligne la plus intéressante est la dernière : « À nuancer ». Elle apparaît quand le modèle en tête sur un usage est moins bien mesuré que celui qu’il devance — moins de sources indépendantes le documentent. L’écart existe, mais il repose sur une base plus fragile, et l’outil le dit plutôt que d’afficher une victoire nette.
C’est un choix éditorial qui a un coût : il rend le verdict moins spectaculaire. Il évite en revanche de transformer une incertitude de mesure en recommandation d’achat.
Usage par usage : le tableau qui montre aussi les trous
Plus bas dans le panneau, le détail complet : une ligne par usage, le score et le rang de chaque modèle, une barre d’écart, et la colonne « Qui gagne ».
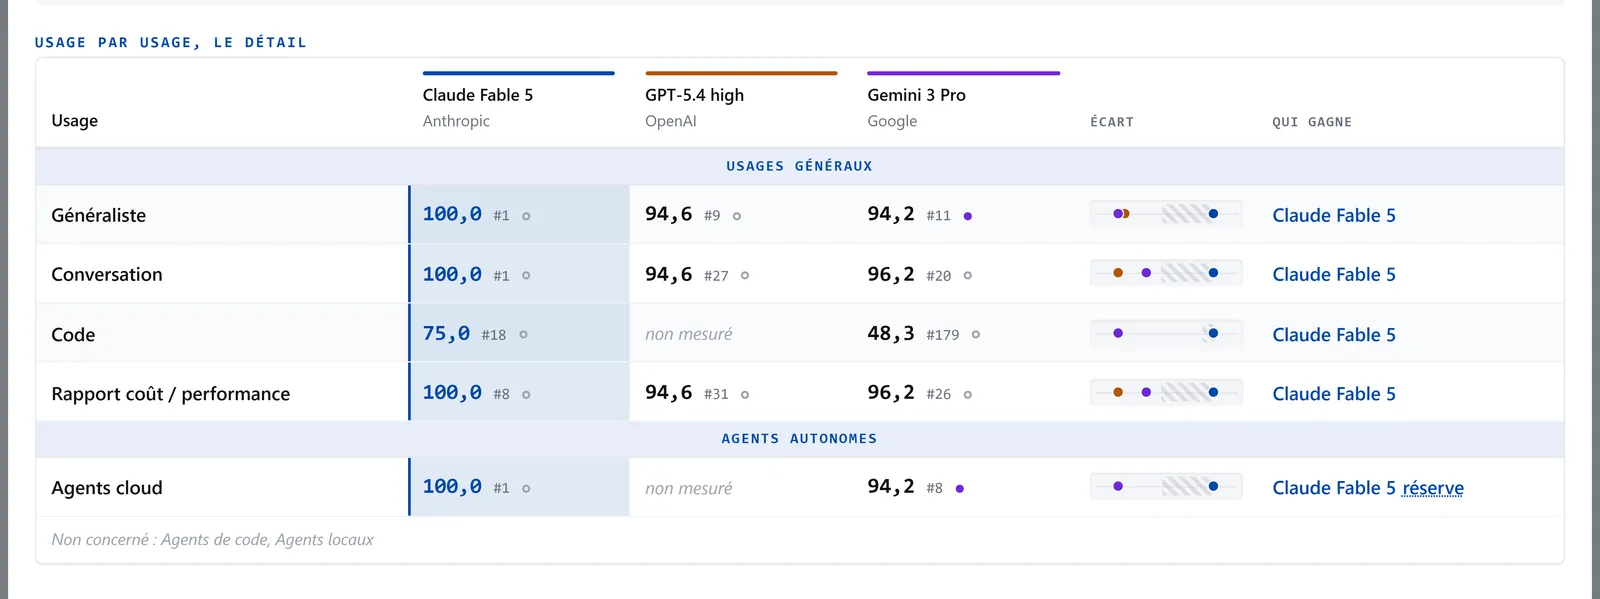
Trois mentions reviennent, et chacune veut dire quelque chose de précis :
- « non mesuré » : aucune source publique ne couvre ce modèle pour cet usage. La case reste vide, rien n’est estimé ni extrapolé ;
- « Non concerné », en bas du tableau : l’usage ne s’applique à aucun des modèles sélectionnés — comparer trois modèles cloud sur la catégorie « Agents locaux » n’aurait aucun sens, la ligne est donc écartée ;
- « réserve » : la victoire est acquise, mais sur une base de mesure plus étroite, comme expliqué plus haut.
Un interrupteur, juste au-dessus, permet de n’afficher que ce qui départage : les lignes à égalité et hors périmètre disparaissent, il ne reste que les usages où un modèle prend réellement l’avantage. Quand on hésite entre deux abonnements, c’est souvent la seule vue qui compte.
Quand le comparateur refuse de trancher
Voici l’écran dont nous sommes le plus fiers, et c’est celui qui affiche le moins de résultats.
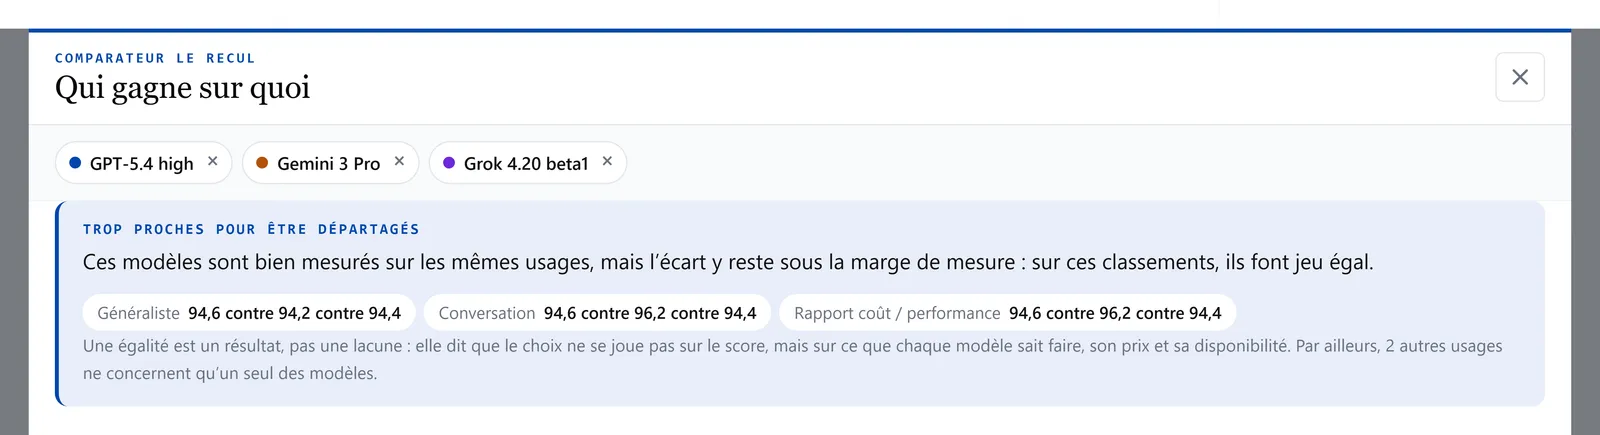
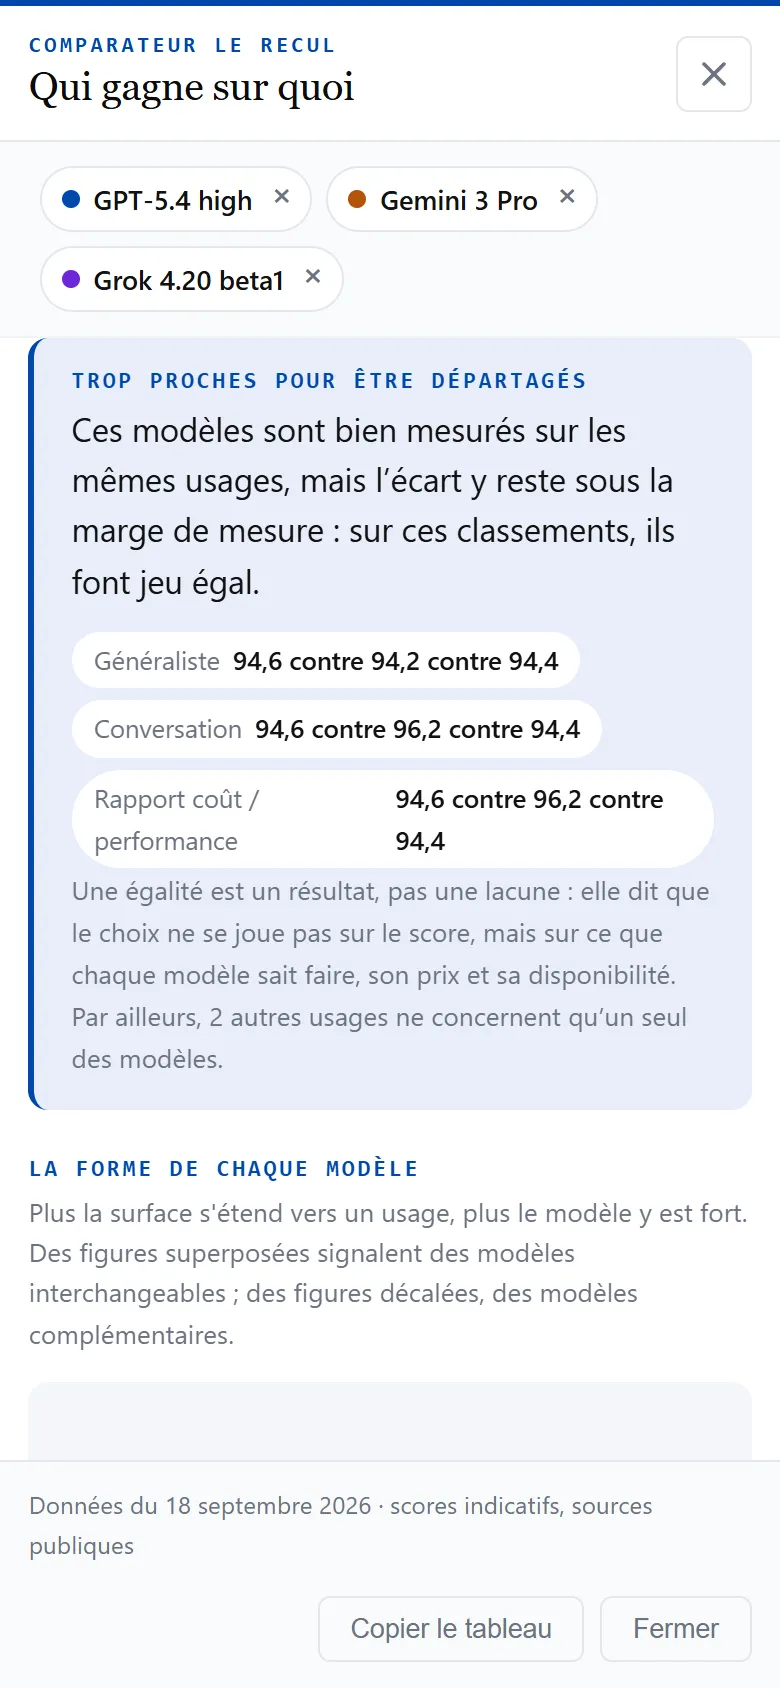
Sur ce trio, les trois scores généralistes du 18 septembre 2026 tenaient dans quatre dixièmes de point : 94,6 contre 94,2 contre 94,4. Trois classements différents les mesurent au coude à coude. Désigner un vainqueur dans ces conditions reviendrait à présenter un arrondi comme un résultat.
Le comparateur affiche donc « Trop proches pour être départagés », et ajoute la phrase qui résume notre position : une égalité est un résultat, pas une lacune. Elle dit que le choix ne se joue pas sur le score, mais sur ce que chaque modèle sait faire, sur son prix et sur sa disponibilité — trois critères qu’aucun benchmark ne mesure à votre place.
Le panneau affiche d’ailleurs, juste au-dessus du détail, la ligne « Abonnement grand public » : au 18 septembre 2026, 23 €/mois pour les offres d’Anthropic et d’OpenAI citées ici, 22 €/mois pour celle de Google, et « Gratuit » pour Grok 4.20 beta1. Quand les scores sont à égalité, le prix redevient l’argument décisif.
Image, vidéo, audio, IA locales : le même outil partout
Le comparateur n’est pas réservé aux assistants de conversation. Il fonctionne à l’identique dans chacune des treize catégories du classement, y compris pour les générateurs d’images, les modèles vidéo, l’audio, et les modèles ouverts qui tournent sur votre propre machine.
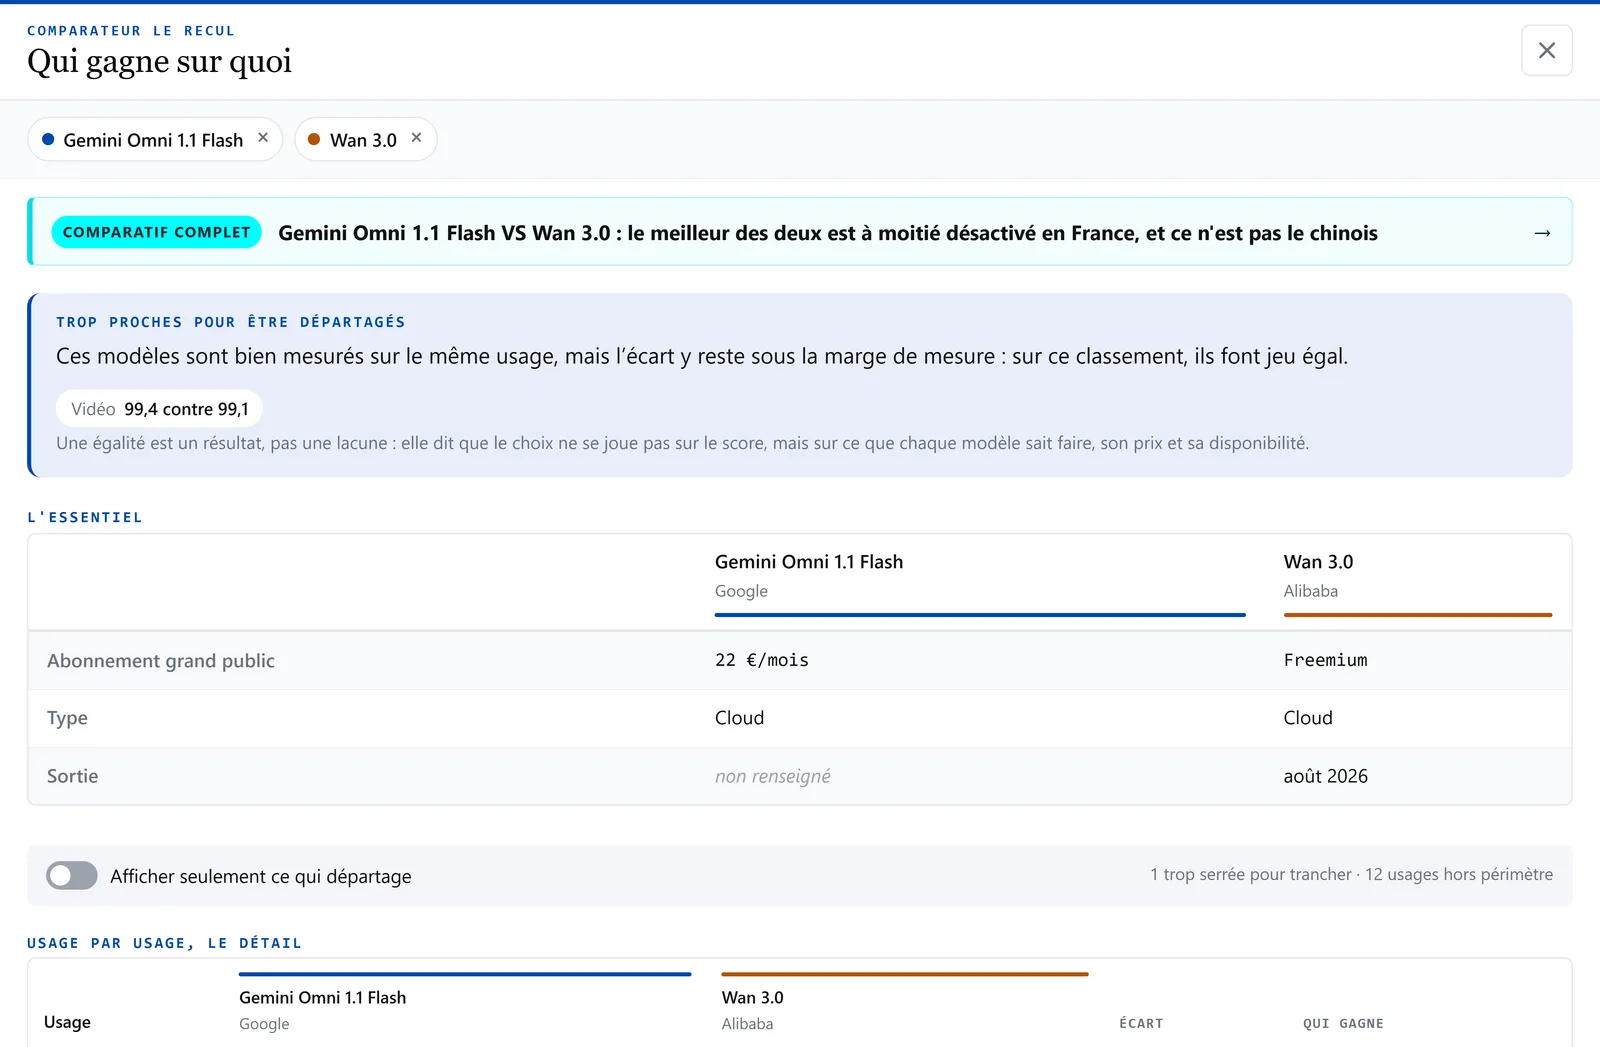
Cette capture montre une dernière fonction, utile quand les chiffres ne suffisent plus : quand nous avons écrit un comparatif complet sur les modèles sélectionnés, le panneau le signale et donne le lien. Ici, 99,4 contre 99,1 en vidéo : égalité statistique, mais notre article explique que le meilleur des deux est à moitié désactivé en France — une différence que n’importe quel score aurait manquée.
Le même principe vaut ailleurs. Pour une IA gratuite, notre comparatif Muse Glimmer face à ChatGPT gratuit détaille ce que l’on perd réellement sans abonnement. Pour une IA qui tourne sur votre ordinateur, sans envoyer vos documents dans le nuage, OpenClaw face à Hermes compare deux agents locaux sous Windows. Le comparateur donne le chiffre ; l’article donne le contexte.
Trois situations concrètes, et par où commencer
Le comparateur donne des chiffres ; encore faut-il savoir lesquels regarder. Voici comment nous l’utiliserions nous-mêmes dans trois cas courants.
Vous débutez et vous ne voulez payer qu’un seul abonnement. Commencez par la catégorie Conversation, pas par le classement généraliste : c’est elle qui mesure ce que vous allez faire tous les jours, écrire, résumer, expliquer, reformuler. Cochez les deux ou trois noms que vous connaissez déjà, lancez la comparaison, et regardez d’abord la ligne « Abonnement grand public ». Si le verdict annonce une égalité, la question n’est plus « lequel est le meilleur » mais « lequel coûte le moins cher et me plaît le plus à l’usage ». Un modèle gratuit qui vous convient bat un modèle payant de trois dixièmes de point supérieur.
Vous codez, ou vous faites coder. Le classement généraliste est le pire des guides possibles : notre relevé du 18 septembre 2026 donnait un écart de 100 à 48,3 entre deux modèles séparés par deux points seulement en usage général. Passez directement par le classement Code, puis regardez la catégorie Agents de code, qui mesure autre chose : la capacité à mener une tâche complète, pas seulement à écrire une fonction juste. Les deux classements ne donnent pas le même ordre, et c’est normal — ils ne posent pas la même question.
Vous décidez pour une petite entreprise. Trois critères pèsent plus que le score brut. Le Rapport coût / performance, qui rapporte les résultats au prix de l’abonnement public — le seul que vous paierez si vous équipez cinq personnes. Les Agents cloud, si vous voulez confier des tâches entières plutôt que poser des questions. Et les catégories Local et Open source, si vos documents ne doivent pas quitter vos machines : un modèle qui tourne sur votre poste ne sera jamais premier du classement général, mais il répond à une contrainte que les premiers ne savent pas satisfaire. Dans ce cas, comparez les modèles locaux entre eux, jamais un modèle local à un modèle cloud — l’outil écarte d’ailleurs automatiquement les usages qui ne concernent aucun des modèles choisis.
Dans les trois cas, le réflexe est le même : choisir la catégorie qui correspond à votre usage réel, cocher deux ou trois finalistes, et n’ouvrir le classement général qu’en dernier — jamais en premier.
D’où viennent les chiffres
Le score affiché n’est pas une note maison sortie d’un chapeau, et ce n’est pas non plus la reprise d’un seul classement. C’est un score composite, calculé à partir de benchmarks publics, normalisé sur 100 et pondéré par catégorie :
- LMArena, où des internautes comparent deux réponses à l’aveugle et votent — la mesure de préférence humaine la plus utilisée ;
- SWE-bench, qui demande à un modèle de corriger de vrais bugs dans de vrais dépôts de code ;
- Aider, en mode Polyglot et architect, pour l’édition de code en conditions réelles ;
- LiveBench, dont les questions sont renouvelées pour limiter la contamination des jeux d’entraînement ;
- MMLU-Pro, du laboratoire TIGER-Lab, pour les connaissances sur quatorze disciplines ;
- BBEH, publié par Google DeepMind, pour le raisonnement difficile ;
- Artificial Analysis, quand la connexion est active, pour la performance, le prix et la vitesse.
Chaque modèle porte un statut d’évaluation : Fiable quand au moins deux sources indépendantes le confirment, ou qu’une source de référence couvre à elle seule au moins 60 % des critères pondérés de la catégorie ; Partiel quand une seule source le documente — souvent un modèle récent, pas encore croisé ; Insuffisant quand la donnée ne permet pas de verdict propre. Ce statut n’est pas décoratif : c’est lui qui déclenche la mention « À nuancer » dans le verdict.
Deux précisions comptent pour l’usage quotidien. D’abord, la catégorie Rapport coût / performance compare la performance au prix de l’abonnement grand public — pas au prix des API facturées au million de jetons, qui ne reflète pas ce que paie un particulier. Ensuite, si une source ne répond pas lors d’un cycle, le classement n’est pas vidé : la dernière mesure fiable est conservée dans une limite de fraîcheur, et un garde-fou bloque toute publication qui dégraderait brutalement les données. La méthodologie complète, y compris les pondérations par catégorie, est dépliable en bas de la page Classement IA.
Ce que le comparateur ne dit pas
Un outil honnête est un outil qui annonce ses angles morts. En voici quatre, sans détour.
Il ne teste pas les modèles lui-même. Il agrège des mesures publiques. Un benchmark mesure ce qu’il sait mesurer, pas votre métier. Les tests que nous menons nous-mêmes vivent dans la rubrique Promesses testées, et ils racontent souvent une autre histoire que les scores.
Il ne mesure pas le français en particulier. La plupart des benchmarks publics sont anglophones. Un modèle excellent en anglais peut être moins à l’aise dans une note de synthèse en français, et aucune colonne ne le dira.
Il ne mesure ni l’interface, ni les limites d’usage, ni la confidentialité. Le nombre de messages par jour, la qualité de l’application mobile, ce que l’éditeur fait de vos données : ces critères pèsent souvent plus lourd, dans la vraie vie, que trois dixièmes de point.
Les scores bougent. Tous les chiffres cités dans cet article sont ceux du 18 septembre 2026. Le classement est recalculé chaque jour ; un modèle nouvellement couvert par une deuxième source peut gagner dix places en une nuit sans que rien n’ait changé dans le modèle lui-même. C’est pourquoi chaque comparaison affiche sa date.
Ce qu’il faut retenir
Si vous ne deviez garder que quatre phrases :
- La meilleure IA n’existe pas : le même modèle peut être 20e sur un usage et 179e sur un autre.
- Trois modèles, treize usages, un verdict : le comparateur répond en trente secondes, gratuitement et sans inscription.
- Une égalité est un résultat. Quand l’écart passe sous la marge de mesure, l’outil le dit — et le choix se reporte alors sur le prix, les fonctions et la disponibilité.
- Les cases vides sont des informations. Un « non mesuré » vaut mieux qu’un chiffre inventé.
Le reste vous appartient : cochez vos deux ou trois finalistes, regardez l’usage qui compte pour vous, et laissez tomber le classement général.
Notre verdict. L’IA promet, Le Recul vérifie : nous ne vous dirons pas quelle IA est la meilleure, parce que personne ne le peut honnêtement. Nous vous disons laquelle gagne sur l’usage qui vous intéresse, de combien, avec quelles sources — et quand la réponse est « c’est trop serré pour trancher ».
Essayez maintenant : le comparateur de modèles IA est ouvert, gratuit et sans inscription. Trois modèles, treize usages, un verdict daté.