Outil

Comparateur de modèles IA

Sélectionnez trois modèles, obtenez le verdict par usage. Aucun test à lancer, aucun prompt à écrire — la comparaison est déjà calculée.

  1. 1Cochez trois modèlesdans le tableau ci-dessous, ou dans n’importe quel classement du site.
  2. 2Lancez la comparaisond’un clic. Rien à installer, rien à créer.
  3. 3Lisez le verdictusage par usage : qui gagne, de combien, et avec quelle solidité de mesure.

Un exemple, calculé aujourd’hui

Claude Opus 4.6Anthropic vsGemini 3 ProGoogle vsGrok 4.20 Beta 0309 ReasoningxAI

Claude Opus 4.6 domine 3 usages · Gemini 3 Pro n’arrive premier sur aucun · Grok 4.20 Beta 0309 Reasoning n’arrive premier sur aucun.

3 usages départagés sur 5 comparables · 2 trop serrés pour trancher · 8 usages hors périmètre

Comparaison usage par usage
Usage Claude Opus 4.6Gemini 3 ProGrok 4.20 Beta 0309 Reasoning Qui gagne
Généraliste 95,3 #4 92,1 #9 90,7 #18 Claude Opus 4.6réserve
Conversation 95,3 #17 93,0 #24 90,7 #46 trop serré
Code 58,6 #193 46,0 #278 37,5 #334 Claude Opus 4.6
Rapport coût / performance 95,3 #18 93,0 #23 90,7 #38 trop serré
Agents cloud 95,3 #3 92,1 #8 90,7 #13 Claude Opus 4.6réserve

Comparaison recalculée à chaque mise à jour du classement. Choisissez vos propres modèles ci-dessous.

Comparez les modèles de votre choix

Comparateur Le Recul

Qui gagne sur quoi

Cochez au moins deux modèles dans le tableau du classement, puis revenez ici.

Cette liste ne montre que les vingt premiers du classement général. Les 1 800 modèles restants — dont ceux de code, d’image, de vidéo, d’audio et les modèles ouverts — se comparent de la même façon depuis le classement complet, où le comparateur fonctionne à l’identique dans chacune des 13 catégories.

Vingt premiers modèles du classement général
# Modèle Éditeur Score
01 Claude Opus 5.5 High Anthropic 96,9 / 100
02 Claude Opus 4 6 High Anthropic 96,3 / 100
03 Claude Opus 4 7 High Anthropic 95,8 / 100
04 Claude Opus 4.6 Anthropic 95,3 / 100
05 Claude Fable 5 High Anthropic 94,6 / 100
06 Claude Opus 4.7 Anthropic 94,6 / 100
07 Claude Opus 4 8 High Anthropic 92,3 / 100
08 Claude Fable 5 1 Max Anthropic 92,2 / 100
09 Gemini 3 Pro Google 92,1 / 100
10 Claude Sonnet 5.5 Xhigh Anthropic 91,4 / 100
11 GPT 5.2 Chat Latest 20260210 OpenAI 91,4 / 100
12 GPT-5.4 high OpenAI 91,3 / 100
13 Grok 4.20 beta1 xAI 91,3 / 100
14 Qwen3.7 Max Preview Alibaba 91,3 / 100
15 Claude Opus 4 5 20251101 High 32k Anthropic 91,1 / 100
16 Claude Opus 4.8 Anthropic 91,1 / 100
17 Claude Sonnet 4.6 Anthropic 90,7 / 100
18 Grok 4.20 Beta 0309 Reasoning xAI 90,7 / 100
19 Grok 4.20 Multi Agent Beta 0309 xAI 90,4 / 100
20 Gemini 3 flash Google 90,2 / 100

Comparer parmi les 1 800 modèles →

Nos comparatifs analysés

L’outil calcule. Nos comparatifs expliquent : contexte, limites, et ce que les chiffres ne disent pas.

Meilleure IA pour coder : Claude Opus 5.5 contre GPT-6 Sol, sortis le même jour à quelques heures d'écart

Comparatifs

Meilleure IA pour coder : Claude Opus 5.5 contre GPT-6 Sol, sortis le même jour à quelques heures d'écart

Le 22 septembre 2026, Anthropic a publié Claude Opus 5.5 et OpenAI a répondu dans la journée avec GPT-6 Sol, moitié moins cher. Les deux sont vendus pour écrire du code. Aucun classement indépendant de programmation ne les a encore mesurés : SWE-bench Verified n'accepte plus les laboratoires commerciaux depuis novembre 2025, et le classement DeepSWE ne les contient pas. Nous avons repris les deux annonces ligne à ligne, croisé la seule mesure indépendante disponible, recalculé chaque facture et lu les grilles tarifaires jusqu'aux seuils. Il en sort trois choses qui ne figurent dans aucune annonce : le réglage par défaut du plus cher bat le réglage maximal du moins cher, l'écart de prix s'effondre exactement là où le code en a besoin, et aucun des deux éditeurs ne s'est comparé à l'autre.
DeepSeek V4.1 Flash VS GPT-5.6 Luna : le moins cher des deux dépend de l'heure à laquelle vous l'appelez

Comparatifs

DeepSeek V4.1 Flash VS GPT-5.6 Luna : le moins cher des deux dépend de l'heure à laquelle vous l'appelez

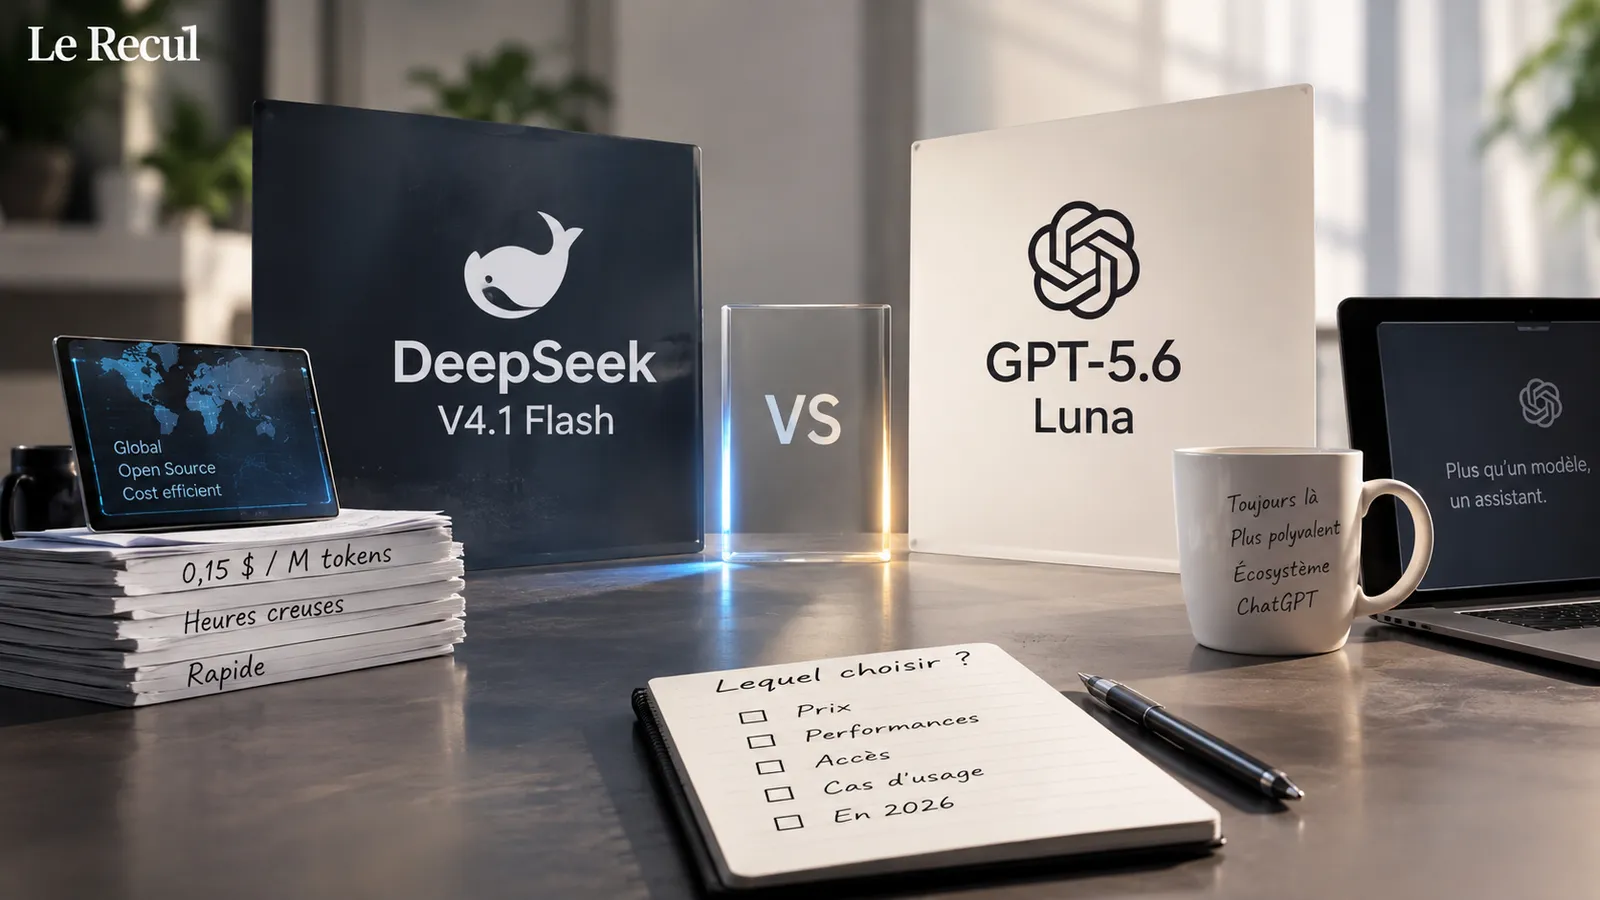
DeepSeek a publié V4.1 Flash le 10 septembre 2026, et le tarif qui circule est spectaculaire : 0,15 dollar le million de jetons. En face, GPT-5.6 Luna, le modèle de ChatGPT gratuit et l'entrée de gamme de la famille GPT-5.6 d'OpenAI. Sur l'indice indépendant de référence, DeepSeek passe devant, 40 contre 38. Mais ce tarif est celui des heures creuses : du lundi au vendredi, les matinées françaises sont facturées le double. DeepSeek écrit aussi deux fois plus de jetons pour la même tâche, et son score record en programmation n'a pas encore été vérifié par le classement officiel. Nous avons recalculé chaque facture, heure par heure.

Mis à jour
Gemini Omni 1.1 Flash VS Wan 3.0 : le meilleur des deux est à moitié désactivé en France, et ce n'est pas le chinois

Comparatifs

Gemini Omni 1.1 Flash VS Wan 3.0 : le meilleur des deux est à moitié désactivé en France, et ce n'est pas le chinois

Google a publié Gemini Omni 1.1 Flash le 27 août 2026, Alibaba a ouvert Wan 3.0 quelques semaines plus tôt. Dans notre classement, trente-cinq centièmes de point les séparent. Nous avons repris les deux annonces mot à mot, recalculé le prix d'une minute livrée essais ratés compris, rassemblé les relevés de ceux qui les font tourner en production, et lu les documentations jusqu'aux restrictions que les éditeurs écrivent en petits caractères. Ce qui en ressort n'est dans aucun communiqué : les quarante secondes de Google sont un empilement de plans de dix, sa 4K est un agrandissement, et la fonction qui fait tout son intérêt — modifier vos propres vidéos — est purement et simplement bloquée en Europe. Pendant ce temps, le chinois génère trente secondes d'un seul tenant, accepte un PDF en entrée, et publie lui-même la liste de ses faiblesses.

Voir tous les comparatifs →

Questions fréquentes

Combien de modèles peut-on comparer à la fois ?

Trois. Au-delà, le tableau devient illisible et la comparaison perd son intérêt : on ne choisit pas entre huit modèles, on choisit entre deux ou trois finalistes.

D’où viennent les scores ?

De sources publiques recoupées, agrégées quotidiennement. Chaque score porte son statut d’évaluation et le nombre de sources indépendantes qui le soutiennent.

Que veut dire « trop serré pour trancher » ?

Que l’écart entre deux modèles est plus petit que la marge d’incertitude de la mesure. Désigner un vainqueur dans ce cas serait un choix arbitraire présenté comme un résultat : le comparateur préfère le dire.

Pourquoi certaines cases indiquent « non mesuré » ?

Parce que le modèle n’apparaît dans aucune source publique pour cet usage. Rien n’est estimé ni comblé : une case vide est une information, pas un oubli.

Faut-il créer un compte ?

Non. Le comparateur est gratuit, sans inscription et sans compte. Aucune donnée personnelle n’est demandée.