Le 10 septembre 2026, DeepSeek a publié V4.1 Flash, le premier modèle de sa génération V4.1 : 552 milliards de paramètres, poids ouverts sous licence MIT, disponible le jour même sur son site, dans son application et dans son API. Le chiffre repris partout tient en trois montants : 0,003 dollar le million de jetons relus depuis le cache, 0,15 dollar en entrée, 0,60 dollar en sortie.
Dans sa fiche technique, DeepSeek se mesure à Claude Opus 5, à GPT-5.6 Sol, à Kimi K3 et à GLM-5.3 — dont les deux premiers sont vendus plus de dix fois plus cher. Il ne se compare jamais au modèle qu’il concurrence réellement sur le prix : GPT-5.6 Luna, l’entrée de gamme de la famille GPT-5.6 d’OpenAI, facturé 0,20 dollar en entrée et 1,20 en sortie, et moteur de ChatGPT gratuit depuis le mois d’août.
C’est ce duel-là que ce comparatif a mesuré. Et le résultat tient moins aux scores qu’à une question que personne ne pose : à quelle heure appelez-vous le modèle ?
Le verdict en bref
Sur l’intelligence : DeepSeek, de peu. Sur la version 4.3 de l’indice d’Artificial Analysis, V4.1 Flash obtient 40, GPT-5.6 Luna 38 à son réglage maximal. Sur les dix épreuves, DeepSeek en gagne cinq, Luna trois, deux sont nulles.
Sur le prix : tout dépend de l’heure. Le tarif qui circule est celui des heures creuses. Du lundi au vendredi, de 8 h à 12 h et de 3 h à 6 h, heure d’été de Paris, DeepSeek facture le double : 0,30 dollar en entrée — plus cher que Luna — et 1,20 en sortie — exactement le prix de Luna.
Sur la facture réelle : avantage Luna, le plus souvent. DeepSeek écrit 2,2 fois plus de jetons que Luna pour accomplir les mêmes tâches. Passer l’intégralité de l’indice coûte 477 dollars chez DeepSeek aux tarifs des heures pleines, 320 chez OpenAI. Aux tarifs des heures creuses, DeepSeek repasse devant, à environ 238 dollars.
Sur le code : avantage DeepSeek là où c’est mesuré, promesse à vérifier ailleurs. DeepSeek annonce 74,2 % sur DeepSWE, ce qui le placerait en tête du classement officiel ; ce score n’y figure pas encore. La mesure indépendante disponible, sur le travail en ligne de commande, est en revanche nette : 27 % contre 12 %.
Sur la vitesse : DeepSeek, largement. Une réponse complète arrive en 12,6 secondes, contre 131 pour Luna à son réglage maximal, réflexion comprise.
Sur l’accès gratuit et les données : deux logiques opposées. ChatGPT gratuit s’utilise même sans compte, et offre le texte illimité aux comptes gratuits. DeepSeek exige une inscription et stocke vos données en Chine. Les deux peuvent se servir de vos conversations pour améliorer leurs modèles. Mais seul DeepSeek offre une sortie de secours : ses poids ouverts, que d’autres hébergeurs servent — ou que vous pouvez installer chez vous.
D’où viennent les chiffres de ce comparatif
Autant poser la méthode avant les chiffres, parce qu’un comparatif ne vaut que par la traçabilité de ce qu’il avance. Quatre familles de données, tenues séparées d’un bout à l’autre :
- Les chiffres des éditeurs viennent des annonces, grilles tarifaires et fiches techniques de DeepSeek et d’OpenAI. Ils font foi pour les prix, les capacités et les limites. Ils sont douteux pour les comparaisons : chacun choisit ses épreuves et ses adversaires, et DeepSeek, on l’a vu, ne s’oppose jamais à Luna.
- Les mesures indépendantes viennent d’Artificial Analysis, qui fait passer la même batterie aux deux modèles et publie ce que les éditeurs taisent — jetons consommés, coût réel, délai de réponse —, et du classement officiel DeepSWE, tenu par Datacurve, qui mesure la programmation réglage par réglage.
- Les préférences d’utilisateurs francophones viennent de compar:IA, le comparateur public porté par le ministère de la Culture, où les internautes départagent à l’aveugle les réponses de deux modèles.
- Nos propres rangs viennent du classement IA du Recul, relevé le 16 septembre 2026. Nous n’y rapprochons que des entrées alimentées par la même famille de sources : deux scores issus de deux harnais différents ne se comparent pas.
Tous les calculs de coût ont été refaits à partir des grilles publiées, avec des hypothèses écrites pour que vous puissiez les rejouer.
Deux trous sont signalés plutôt que comblés : la qualité du français, qu’aucun des deux éditeurs n’évalue publiquement, et le score de programmation de V4.1 Flash, que le classement officiel n’a pas encore mesuré — le modèle est sorti le 10 septembre.
Les deux adversaires
| DeepSeek V4.1 Flash | GPT-5.6 Luna | |
|---|---|---|
| Éditeur | DeepSeek (Chine) | OpenAI (États-Unis) |
| Sortie | 10 septembre 2026 | 9 juillet 2026 ; modèle de ChatGPT gratuit depuis août |
| Identifiant API | deepseek-flash | gpt-5.6-luna |
| Architecture | mélange d'experts, 552 milliards de paramètres, 8 milliards actifs en lecture et 16 en écriture | non indiquée dans la fiche |
| Poids | ouverts, licence MIT | fermés |
| Contexte | 1 000 000 jetons | 1 050 000 jetons, dont 922 000 au maximum en entrée |
| Sortie maximale | 384 000 jetons | 128 000 jetons |
| Entrée / sortie | texte et images / texte | texte et images / texte |
| Réflexion | activée par défaut, effort réglable de 1 à 100 | none, low, medium (par défaut), high, xhigh, max |
| Prix par million de jetons | 0,30 $ / 1,20 $ en heures pleines ; 0,15 $ / 0,60 $ en heures creuses | 0,20 $ / 1,20 $ à toute heure |
| Entrée relue en cache | 0,006 $ (pleines) ; 0,003 $ (creuses) | 0,02 $ |
| Surcoût long contexte | aucun dans la grille | ×2 en entrée et ×1,5 en sortie au-delà de 272 000 jetons |
Deux lignes de ce tableau pèsent plus lourd qu’elles n’en ont l’air. Chez DeepSeek, la réflexion est activée par défaut, et les scores de sa fiche sont obtenus à l’effort maximal, 100. Chez OpenAI, le réglage par défaut de l’API est medium — et on verra qu’il change tout.
Le prix affiché est celui des heures creuses
DeepSeek facture selon l’heure. Sa grille distingue des heures pleines, du lundi au vendredi de 1 h à 4 h et de 6 h à 10 h en temps universel, et des heures creuses — tout le reste de la semaine, week-end compris —, facturées exactement moitié prix.
Ces plages ont été calées sur la Chine : à Pékin, elles couvrent 9 h-12 h et 14 h-18 h, la journée de bureau. Traduites en heure de Paris, elles tombent sur la matinée de travail française.
| Heures pleines, du lundi au vendredi | Heure de Paris |
|---|---|
| Jusqu'au 24 octobre 2026 (heure d'été) | 3 h - 6 h et 8 h - 12 h |
| À partir du 25 octobre 2026 (heure d'hiver) | 2 h - 5 h et 7 h - 11 h |
Et voici ce que devient la comparaison, ligne à ligne :
| Par million de jetons | DeepSeek, heures pleines | DeepSeek, heures creuses | GPT-5.6 Luna |
|---|---|---|---|
| Entrée relue en cache | 0,006 $ | 0,003 $ | 0,02 $ |
| Entrée normale | 0,30 $ | 0,15 $ | 0,20 $ |
| Sortie | 1,20 $ | 0,60 $ | 1,20 $ |
En heures creuses, DeepSeek est 25 % moins cher que Luna en entrée et deux fois moins cher en sortie. En heures pleines, il est 50 % plus cher en entrée et au même prix en sortie. Seul le cache reste nettement à son avantage à toute heure, trois à sept fois moins cher.
Pour une entreprise française ouverte de 9 h à 18 h, un tiers des heures de bureau tombe en heures pleines jusqu’au changement d’heure, un peu plus d’un cinquième ensuite. Un traitement lancé la nuit ou le week-end, lui, profite du tarif réduit en entier.
Le prix du jeton n’est pas la facture
Un tarif au million de jetons ne dit rien du nombre de jetons qu’un modèle consomme pour faire son travail. C’est précisément là que les deux adversaires divergent le plus.
Artificial Analysis publie, pour chaque modèle, ce qu’il en a coûté de lui faire passer l’intégralité de son indice — les mêmes dix épreuves, aux tarifs de l’éditeur, en comptant le cache, le raisonnement et la réponse. Il publie aussi le nombre de jetons écrits par tâche.
| Mesuré sur la même batterie | DeepSeek V4.1 Flash (max) | Luna (max) | Luna (xhigh) |
|---|---|---|---|
| Indice d'intelligence v4.3 | 40 | 38 | 35 |
| Jetons écrits par tâche | 89 000 | 41 000 | 24 000 |
| dont raisonnement | 63 000 | 28 000 | 15 000 |
| Coût mesuré de l'indice complet (DeepSeek aux tarifs pleins) | 477 $ | 320 $ | 179 $ |
| Même coût, DeepSeek aux tarifs des heures creuses (notre calcul) | environ 238 $ | 320 $ | 179 $ |
DeepSeek écrit 2,2 fois plus que Luna à son réglage maximal, et 3,7 fois plus qu’au réglage juste en dessous. Son seul raisonnement pèse plus lourd que toute la production de Luna au maximum.
D’où un renversement que la grille tarifaire ne laisse pas voir : aux tarifs pleins — ceux qu’utilise Artificial Analysis —, DeepSeek coûte 49 % de plus que Luna pour passer le même examen. Aux tarifs des heures creuses, il coûte 25 % de moins. La dernière ligne est notre calcul, et il est exact : tous les tarifs de DeepSeek étant divisés par deux, la facture l’est aussi.
Le réglage xhigh de Luna mérite un détour : trois points d’indice de moins que le maximum, pour une facture 1,8 fois plus légère. À ce réglage, Luna reste moins cher que DeepSeek à toute heure — mais il devient le moins intelligent des trois.
DeepSeek assume d’ailleurs ce mécanisme. Selon les chiffres repris par VentureBeat, porter son effort de réflexion de 25 à 100 fait passer son score de programmation de 66,0 % à 74,2 %, pour environ 2,5 fois plus de jetons de sortie. La qualité s’achète en volume. Le prix affiché est celui du jeton ; la facture est celle du travail.
Le calcul qui décide : à partir de combien de jetons DeepSeek coûte plus cher
Prenons un usage courant — un assistant intégré à un outil métier — et écrivons les hypothèses pour que chacun puisse les rejouer :
- 100 000 requêtes par mois ;
- 3 000 jetons d’entrée par requête, dont 2 000 d’instructions répétées, relues depuis le cache, et 1 000 nouveaux ;
- 500 jetons de sortie par requête chez Luna.
Chez OpenAI, la facture est de 84 dollars par mois, à toute heure.
Chez DeepSeek, elle dépend de deux inconnues : l’heure, et le nombre de jetons que le modèle écrira pour faire le même travail. Appelons k ce rapport : k = 1 s’il écrit autant que Luna, k = 2 s’il écrit deux fois plus. Le rapport mesuré par Artificial Analysis sur son indice est de 2,17.
| Facture mensuelle DeepSeek | si k = 1 | si k = 2,17 | Plus cher que Luna dès que k dépasse |
|---|---|---|---|
| Tout en heures pleines | 91,20 $ | 161,40 $ | 0,88 |
| Tout en heures creuses | 45,60 $ | 80,70 $ | 2,28 |
| Journée de bureau 9 h-18 h, heure d'été | 60,80 $ | 107,60 $ | 1,58 |
| Journée de bureau 9 h-18 h, heure d'hiver | 55,73 $ | 98,63 $ | 1,77 |
Trois lectures. En heures pleines, DeepSeek coûte plus cher que Luna dès qu’il écrit 88 % de ce qu’écrit Luna — autrement dit, presque toujours. En heures creuses, il reste moins cher tant qu’il n’écrit pas plus de 2,28 fois plus : le rapport mesuré, 2,17, passe juste sous la barre. Sur une journée de bureau française, le seuil tombe à 1,58 l’été et 1,77 l’hiver : au rapport mesuré, DeepSeek coûte alors 28 % de plus que Luna en été et 17 % de plus en hiver.
Une réserve, qui compte : ce rapport de 2,17 a été mesuré sur des épreuves exigeantes, réflexion poussée au maximum. Sur des requêtes simples, l’écart peut être très différent. C’est la seule mesure à faire sur votre propre charge avant de choisir ; le calcul, lui, reste le même.
Et il existe une troisième voie que la grille de DeepSeek ne montre pas. Ses poids étant ouverts, d’autres hébergeurs le vendent à leurs propres conditions : Artificial Analysis recense sept fournisseurs, DeepSeek compris, avec des prix qui varient jusqu’à 4,9 fois. Databricks l’affiche à 0,14 dollar en entrée et 0,28 en sortie — moins cher que DeepSeek lui-même en heures creuses.
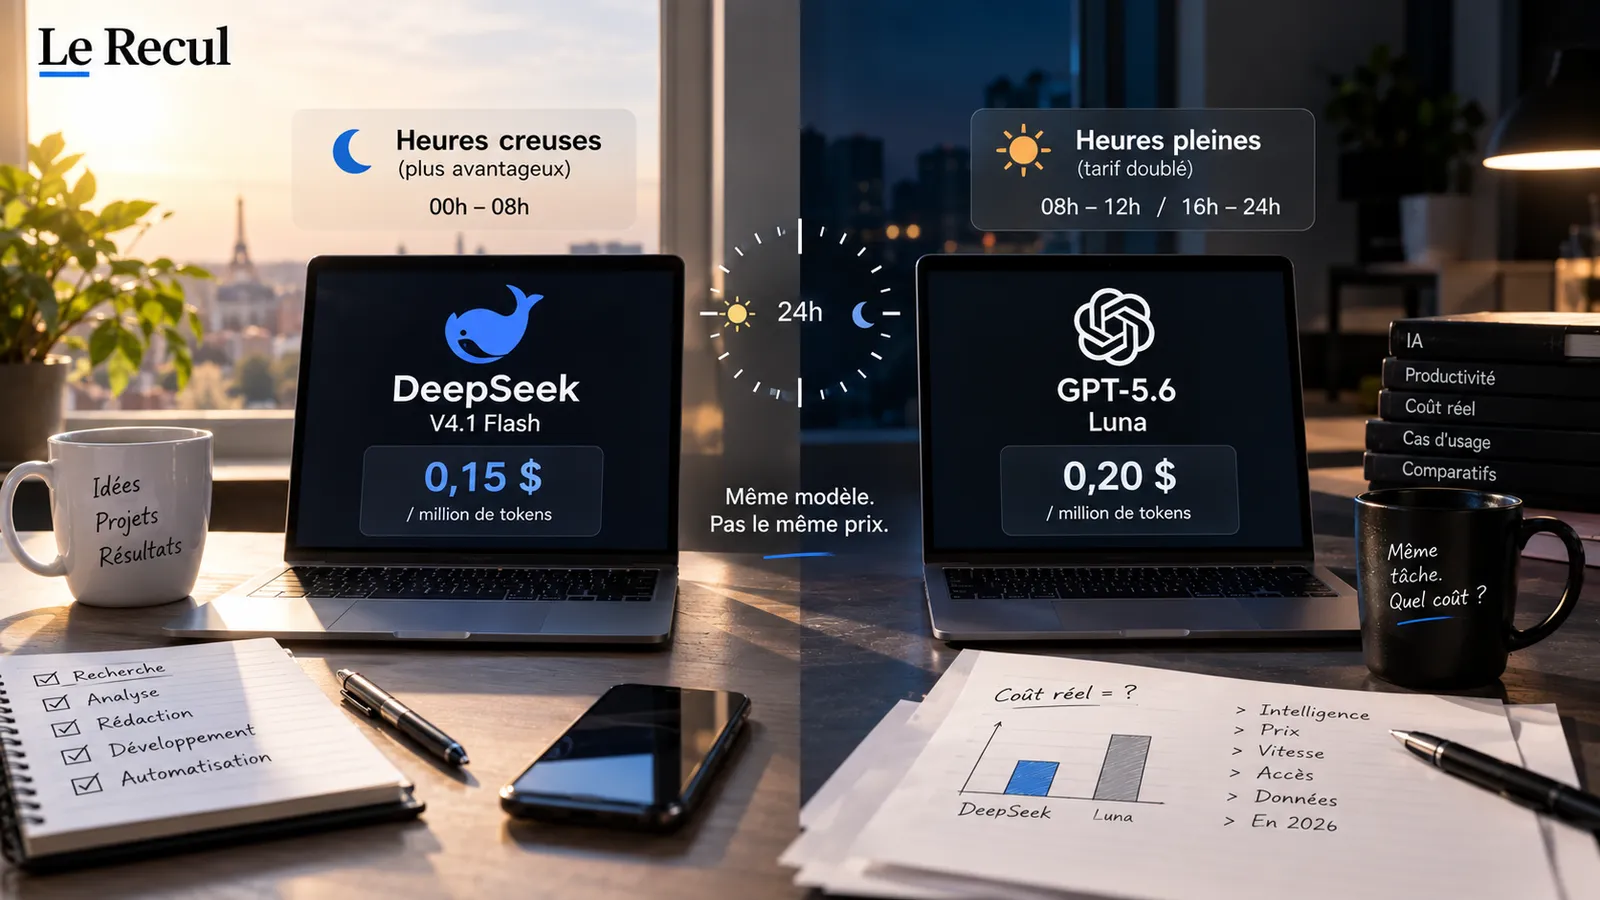
Le prix affiché au million de jetons ne suffit pas : selon l’heure d’utilisation et la quantité réellement générée, la facture finale peut changer fortement.
L’intelligence : 40 contre 38, et une répartition qui dit tout
Tous les chiffres qui suivent viennent de la version 4.3 de l’indice d’Artificial Analysis. Ce composite est versionné, et changer de version change les scores : des valeurs publiées sous une version antérieure, y compris dans d’anciens comparatifs, ne se comparent pas à celles-ci.
| Épreuve | Ce qu'elle mesure | DeepSeek | Luna (max) |
|---|---|---|---|
| AA-Briefcase | travail sur dossiers | 1424 | 1333 |
| GDPval-AA v2 | travail de connaissance | 1632 | 1462 |
| AutomationBench-AA | flux métier automatisés | 69 % | 50 % |
| Terminal-Bench 4.0 | travail en ligne de commande | 27 % | 12 % |
| SciCode | code scientifique | 52 % | 54 % |
| Humanity's Last Exam | questions expertes très difficiles | 39 % | 39 % |
| GDP.pdf | lecture de documents | 13 % | 24 % |
| CritPt | physique de recherche | 14 % | 21 % |
| AA-Omniscience | fiabilité, hallucination | −5 | −10 |
| AA-LCR v1.1 | raisonnement sur long contexte | 84 % | 84 % |
Cinq épreuves à DeepSeek, trois à Luna, deux nulles. L’écart global de deux points est faible ; sa répartition, elle, est tranchée.
DeepSeek gagne là où il faut agir : dix-neuf points d’avance sur l’automatisation de flux métier, un score plus que doublé sur le terminal, et une avance nette sur le travail de dossier. Luna gagne là où il faut lire : un document PDF, un problème de physique de recherche.
C’est la surprise du tableau. DeepSeek met en avant sa compréhension visuelle native, pré-entraînée sur un corpus mêlant images et texte, et sa fiche revendique 95,6 sur DocVQA pour son modèle de base. C’est pourtant sur la lecture de documents qu’il cède le plus nettement : 13 % contre 24 %, presque deux fois moins.
Comme au sommet du marché, où le peloton de tête est devenu une foule, l’entrée de gamme se joue désormais à deux points d’indice. Ce n’est plus le total qui doit guider le choix, c’est la ligne du tableau qui correspond à votre usage.
Le code : une promesse que le classement officiel n’a pas encore vérifiée
Sur la programmation, DeepSeek frappe fort dans sa fiche : 74,2 % sur DeepSWE v1.1, une batterie de 113 tâches de développement logiciel. Ce score le placerait en tête du classement officiel tenu par Datacurve, devant GPT-6 Astra (74,1 %), Gemini 3.8 Flash (73,8 %) et Claude Opus 5 (73,6 %).
Problème : au 16 septembre 2026, V4.1 Flash n’y figure pas. Côté DeepSeek, le classement officiel s’arrête à V4 Flash (53,3 %) et à V4 Pro (62,8 %). Le 74,2 % reste donc, à ce jour, un chiffre d’éditeur.
Faut-il s’en méfier ? Le passé plaide plutôt pour DeepSeek. Pour ses deux modèles précédents, sa fiche annonçait 54,4 % et 62,7 % ; le classement officiel a mesuré 53,3 % et 62,8 %. Un point d’écart d’un côté, un dixième de l’autre. La promesse est crédible ; elle n’est pas vérifiée.
La seule mesure indépendante déjà publiée sur V4.1 Flash va dans le même sens. Sur Terminal-Bench 4.0, Artificial Analysis relève 27 % contre 12 % pour Luna à son maximum. DeepSeek, lui, annonçait 31,2 % : l’écart habituel entre le harnais d’un éditeur et celui d’un évaluateur indépendant.
Notre classement du code confirme la tendance sur une base comparable. Dans la série alimentée par l’arène de développement web de LMArena, la seule où les deux modèles sont mesurés de la même façon, V4.1 Flash se classe 27e et Luna, dans son réglage xhigh, 78e.
Le piège du réglage par défaut chez OpenAI
Le classement officiel DeepSWE contient une information que personne ne met en avant : il a mesuré Luna à chacun de ses niveaux de réflexion. La chute est vertigineuse.
| GPT-5.6 Luna, réglage | Tâches résolues au premier essai | Coût moyen par tâche |
|---|---|---|
| max | 67,2 % | 0,61 $ |
| xhigh | 56,9 % | 0,31 $ |
| high | 44,2 % | 0,16 $ |
| medium, le réglage par défaut de l'API | 11,3 % | 0,04 $ |
| low | 1,5 % | 0,01 $ |
Au réglage par défaut, Luna résout une tâche de programmation sur neuf. Au maximum, deux sur trois. Six fois plus de réussite pour quatorze fois plus de dépense — soit, en valeur absolue, 61 centimes par tâche.
C’est l’erreur la plus coûteuse de ce comparatif, et elle est gratuite à éviter : un développeur qui branche Luna sans toucher au paramètre de réflexion teste un modèle qui n’a presque rien à voir avec celui des classements. La même vigilance vaut chez DeepSeek, dont la réflexion est certes active par défaut, mais dont les scores publiés sont obtenus à l’effort maximal.
La vitesse : dix fois plus rapide, et pourquoi il faut s’en méfier
Artificial Analysis mesure une écriture à 218 jetons par seconde pour DeepSeek, contre 115 pour Luna au maximum. Mais le chiffre qui compte pour l’utilisateur est le délai d’une réponse complète de 500 jetons, réflexion comprise : 12,6 secondes chez DeepSeek, 131 secondes chez Luna au maximum, 45,8 secondes au réglage xhigh.
Plus de deux minutes d’attente pour une réponse : à son réglage maximal, Luna n’est pas un outil de conversation, c’est un outil de traitement en arrière-plan.
La réserve habituelle vaut ici plus qu’ailleurs : la vitesse est le chiffre le moins fiable d’un comparatif. Elle dépend du temps de réflexion, qui varie avec la difficulté de la question, et plus encore de l’hébergeur. Pour le même DeepSeek V4.1 Flash, Artificial Analysis relève des débits allant de 106 à 539 jetons par seconde selon le fournisseur.
Les faits : lequel invente le moins ?
AA-Omniscience, l’épreuve de fiabilité d’Artificial Analysis, récompense les bonnes réponses, pénalise les réponses inventées et ne sanctionne pas l’abstention. Son échelle va de −100 à 100 ; zéro correspond à un modèle qui répond juste aussi souvent que faux.
Les deux sont sous zéro : DeepSeek à −5, Luna à −10 au maximum et −11 au réglage xhigh. Sur les questions de connaissances de cette épreuve, les deux modèles se trompent donc un peu plus souvent qu’ils ne trouvent ; DeepSeek, un peu moins que Luna.
OpenAI avance de son côté un progrès : dans une évaluation interne portant sur des questions financières, médicales et juridiques, les réponses de Luna comportant au moins une erreur factuelle seraient environ 62 % moins fréquentes qu’avec GPT-5.5 Instant. C’est une mesure d’éditeur, dont l’annonce ne détaille pas le protocole.
Côté DeepSeek, un chiffre de sa propre fiche mérite l’attention. Sur SimpleQA-Verified, qui interroge les connaissances factuelles, le modèle de base de V4.1 Flash obtient 42,3, contre 55,2 pour celui de V4 Pro. Ce qui mène au point que DeepSeek ne met pas en avant.
Ce que DeepSeek ne souligne pas : son modèle Pro a été remplacé par le Flash
Depuis le 14 septembre 2026 à 4 h en temps universel, toutes les requêtes adressées à deepseek-v4-pro sont servies par V4.1 Flash, au tarif de V4.1 Flash, en attendant un V4.1 Pro dont la date n’est pas annoncée.
DeepSeek présente la bascule comme une amélioration, et sur le travail d’agent elle en est une : sa fiche donne au nouveau modèle 31,2 % sur Terminal-Bench 4.0 contre 12,4 % à l’ancien Pro, et 74,2 % contre 62,7 % sur DeepSWE.
Mais la même fiche montre que V4.1 Flash en sait moins. Pour les modèles de base : 42,3 contre 55,2 sur SimpleQA-Verified, 45,2 contre 51,5 sur LongBench-V2, l’épreuve de compréhension des longs documents, 45,5 contre 50,9 sur MultiLoKo, qui teste des connaissances locales en plusieurs langues. Dans leur version finale, à effort maximal : 36,8 contre 42,7 sur Humanity’s Last Exam.
Pour une application qui appelait V4 Pro afin d’exploiter ses connaissances, la réponse a changé du jour au lendemain, sans changement d’identifiant. VentureBeat relève qu’une migration de modèle derrière un identifiant existant peut invalider les tests de non-régression. Et DeepSeek reconnaît lui-même, selon la même source, que des erreurs de sélection de son mécanisme d’attention compressée pourraient dégrader les capacités « dans des cas limites non testés ».
La facture, elle, a fondu : les utilisateurs de l’ancien Pro paient désormais 4,4 fois moins en entrée et 3,3 fois moins en sortie, aux tarifs des heures pleines. En mai, nous racontions comment DeepSeek avait rendu permanente une baisse de 75 % sur V4 Pro. Quatre mois plus tard, ce modèle n’est plus servi du tout.
Le long contexte : un seuil chez OpenAI, aucun dans la grille de DeepSeek
Les deux modèles acceptent environ un million de jetons. Mais OpenAI applique un seuil : au-delà de 272 000 jetons d’entrée, la requête est facturée deux fois plus cher en entrée et 1,5 fois plus cher en sortie. La grille de DeepSeek ne prévoit rien de tel.
Exemple, pour une requête de 300 000 jetons d’entrée et 5 000 de sortie. Sans le seuil, Luna la facturerait 0,066 dollar ; seuil franchi, elle coûte 0,129 dollar. Chez DeepSeek : 0,096 dollar en heures pleines, 0,048 en heures creuses.
Sur les très longues requêtes, DeepSeek est donc moins cher à toute heure. Il écrit aussi plus long d’une traite : 384 000 jetons de sortie maximum, contre 128 000. Deux réserves toutefois : sa fiche montre un recul face à V4 Pro sur LongBench-V2, et Artificial Analysis mesure les deux adversaires à égalité parfaite, 84 %, sur son épreuve de raisonnement sur long contexte.
Côté grand public : l’application DeepSeek contre ChatGPT gratuit
Pour la plupart des lecteurs, la question n’est pas l’API mais « DeepSeek ou ChatGPT ? ». Or les deux modèles de ce comparatif sont précisément ceux des deux offres gratuites.
ChatGPT gratuit tourne sur GPT-5.6 Luna depuis la semaine du 6 août 2026. OpenAI y a ajouté des conversations textuelles illimitées et un bouton Réfléchir pour les questions difficiles, « sous réserve de mesures de protection contre les abus ». Les limites demeurent sur les fichiers, les images et les autres outils. L’annonce ne dit pas quel niveau de réflexion correspond au mode par défaut, ni au bouton Réfléchir — un détail qui n’en est pas un, vu l’écart entre réglages mesuré plus haut. Nous avions détaillé ce que contient réellement ce palier dans notre comparatif Muse Glimmer contre ChatGPT gratuit.
DeepSeek V4.1 Flash est servi sur le site et dans l’application de DeepSeek depuis son lancement, le 10 septembre.
Première différence, visible dès la page d’accueil. Au 16 septembre 2026, chatgpt.com permet de poser une question sans compte, en prévenant que les discussions peuvent être examinées et utilisées pour améliorer les modèles. chat.deepseek.com s’ouvre sur un écran de connexion : numéro de téléphone ou adresse électronique, compte Google ou compte Apple. Pour qui cherche « DeepSeek gratuit sans inscription », le site officiel n’en propose pas.
Deuxième différence, et c’est la seule mesure fondée sur des votes francophones. Sur compar:IA, où 259 000 votes à l’aveugle départagent 83 modèles, GPT-5.6 Luna obtient 1 099 points et DeepSeek V4 Flash, la version précédente, 1 063. Les marges d’incertitude se recouvrent en partie — de 1 070 à 1 111 d’un côté, de 1 039 à 1 083 de l’autre —, mais compar:IA range les deux modèles dans deux classes distinctes, la troisième et la quatrième. Détail révélateur : les votants y préfèrent aussi V4 Flash à V4 Pro, classé 1 044.
V4.1 Flash, sorti le 10 septembre, n’y figure pas encore au relevé du 16. Et compar:IA prévient lui-même que son classement reflète des préférences subjectives, sans mesurer ni la factualité des réponses ni la performance globale des modèles.
Vos données : la Chine, les États-Unis, et la sortie de secours des poids ouverts
Sur les données, les deux offres gratuites ont un point commun qu’on oublie : toutes deux se réservent le droit d’utiliser vos conversations pour améliorer leurs modèles.
Chez DeepSeek, la politique de confidentialité mise à jour le 10 février 2026 est explicite : les données personnelles sont collectées, traitées et stockées en République populaire de Chine, et servent notamment à entraîner les modèles, avec une possibilité de s’y opposer. Une clause dédiée à l’Espace économique européen, à la Suisse et au Royaume-Uni désigne un représentant, le groupe Prighter, et des entités du groupe DeepSeek interviennent pour le stockage, la sécurité et la recherche. Chez OpenAI, le bandeau de ChatGPT sans compte résume la règle en une phrase : les discussions peuvent être utilisées pour améliorer les modèles.
Mais DeepSeek dispose d’un atout qu’un modèle fermé ne peut pas offrir : ses poids sont publics, sous licence MIT. N’importe quelle organisation peut les télécharger, les installer sur ses propres serveurs ou les acheter à l’hébergeur de son choix — les sept fournisseurs recensés par Artificial Analysis, avec des débits de 106 à 539 jetons par seconde. Dans ce cas, c’est la politique de données de l’hébergeur qui s’applique, pas celle de DeepSeek.
D’où le paradoxe de ce match : le modèle chinois est celui dont on peut le mieux choisir le lieu de traitement — à condition de ne pas passer par son éditeur. Nous avions analysé cette stratégie des poids ouverts en expliquant pourquoi la Chine donne ses meilleures IA gratuitement.
L’installation maison reste réservée aux structures équipées. Même si seuls 8 à 16 milliards de paramètres travaillent à chaque jeton, les 552 milliards doivent être stockés et chargés. Pour les déploiements à grande échelle, DeepSeek invite les organisations disposant de 2 000 processeurs graphiques et d’une grappe de stockage à le contacter, selon VentureBeat.
Et en français ?
Aucune des fiches publiées par DeepSeek et par OpenAI pour ces deux modèles ne contient d’évaluation en français. Les dix épreuves de l’indice indépendant sont très majoritairement anglophones.
Deux indices seulement. Dans sa fiche, DeepSeek publie MGSM, une épreuve de mathématiques multilingue : V4.1 Flash y recule, à 80,2 contre 85,7 pour V4 Flash. Et compar:IA, seul classement nourri par des votes francophones, place Luna devant la version précédente de DeepSeek.
Aucun des deux ne mesure la qualité du français elle-même — tournures, registre, justesse des références culturelles. Pour un rédacteur, un juriste ou un service client francophone, c’est pourtant le critère qui devrait décider. Nous signalons le trou plutôt que de le combler.
Lequel choisir
Prenez DeepSeek V4.1 Flash si vous faites tourner des agents qui agissent — terminal, automatisation, enchaînement d’outils —, si vos traitements peuvent tourner l’après-midi, la nuit ou le week-end, si vos requêtes dépassent régulièrement 272 000 jetons, si la vitesse de réponse compte, ou si vous voulez pouvoir héberger le modèle vous-même ou chez un tiers de votre choix.
Prenez GPT-5.6 Luna si vous traitez des documents PDF, si vos appels tombent surtout le matin en semaine, si votre volume de sortie est élevé et que chaque jeton écrit compte, ou si vous voulez un accès gratuit sans inscription pour un usage courant. Et réglez sa réflexion : au défaut, il ne résout qu’une tâche de programmation sur neuf.
Pour un usage grand public, ChatGPT gratuit reste le plus simple : utilisable sans compte, illimité en texte une fois inscrit, préféré par les votants de compar:IA à la version précédente de DeepSeek. L’application DeepSeek offre un modèle plus récent et plus rapide, au prix d’un compte obligatoire et d’un stockage de vos échanges en Chine.
Pour la programmation, patientez quelques jours : si le classement officiel DeepSWE confirme le 74,2 % annoncé, DeepSeek V4.1 Flash rejoindra le peloton de tête en code, à un tarif au jeton plusieurs fois inférieur à celui de Claude Opus 5 ou de GPT-5.6 Sol. Tant que ce n’est pas le cas, c’est une promesse — crédible, mais une promesse.
Ce qu’il faut retenir
- DeepSeek passe devant, de peu. 40 contre 38 sur l’indice Artificial Analysis v4.3 ; cinq épreuves à DeepSeek, trois à Luna, deux nulles.
- Le tarif qui circule est celui des heures creuses. Du lundi au vendredi, de 8 h à 12 h et de 3 h à 6 h, heure de Paris, DeepSeek facture le double : plus cher que Luna en entrée, au même prix en sortie.
- DeepSeek écrit 2,2 fois plus de jetons. Passer le même examen lui coûte 477 dollars aux tarifs pleins, contre 320 pour Luna ; environ 238 aux tarifs des heures creuses.
- Sur une journée de bureau française, DeepSeek devient plus cher dès qu’il écrit 1,58 fois plus que Luna en été, 1,77 fois en hiver. Le rapport mesuré est de 2,17.
- Le 74,2 % en programmation n’est pas encore vérifié par le classement officiel DeepSWE — mais les deux précédentes annonces de DeepSeek y ont été confirmées à un point près.
- Au réglage par défaut de l’API, Luna résout 11,3 % des tâches de code, contre 67,2 % au maximum.
- DeepSeek répond dix fois plus vite que Luna au maximum : 12,6 secondes contre 131, réflexion comprise.
- Depuis le 14 septembre, V4 Pro n’est plus servi : ses requêtes partent vers V4.1 Flash, moins cher, plus fort en agentique, mais moins savant.
- ChatGPT gratuit s’utilise sans compte ; DeepSeek exige une inscription et stocke vos données en Chine. Les deux peuvent utiliser vos conversations pour améliorer leurs modèles.
- Les poids ouverts sont la vraie sortie de secours de DeepSeek : sept fournisseurs, jusqu’à 4,9 fois d’écart de prix, et la possibilité de tout garder chez soi.